她的声音被AI播了32亿次:全国首例AI生成声音侵权案,法院判赔25万
对于人工智能技术处理后的声音,一般社会公众或者一定范围内的公众根据音色、语调和发音风格,能够识别出特定自然人的,则该声音属于自然人声音权益的保护范围。未经自然人许可使用经人工智能技术处理的声音,构成对自然人声音权益的侵权。
人民法院案例库入库编号:2025-07-2-474-001 |
2023年5月,配音演员殷某某在几个知名App里,听到了自己的声音。
那些内容不是她配的。她顺着声音一路溯源,追到某平台上一款文本转语音产品——输入文字,跳出来的声音和她几乎一模一样。再往上追,追出了五家公司串成的一条产业链。
而这条链的起点,是2019年她为一家文化公司录过的一部录音制品。
一部录音制品,怎么变成32亿次播放
链条是这样的:
被告二某(北京)文化传媒公司,2019年委托殷某某录制录音制品,是该录音制品的著作权人。2019年5月10日,它与被告三某软件(中国)有限公司签订《数据授权使用协议》,把包括殷某某录音在内的录音数据提供给软件公司——同时交付了一份并非殷某某本人签字的《数据授权书》。
被告三软件公司仅以殷某某的一部录音制品作为素材,用人工智能等技术处理,生成了案涉文本转语音产品,放在被告四上海某网络科技公司运营的云服务平台对外出售。被告五北京某科技发展公司向被告三下单采购了这款产品,再卖给被告一北京某智能科技公司。被告一以应用程序接口(API)形式,未经技术处理,直接调取并生成文本转语音产品,在自己的平台中使用。
平台显示,案涉声音的播放量为 3,256,728,530 次。
殷某某起诉,请求判令被告一、被告三停止侵权、赔礼道歉,五被告赔偿经济损失50万元、精神损失10万元。一审审理过程中,被告一、被告三下架了案涉产品。
北京互联网法院于2024年作出(2023)京0491民初12142号民事判决:被告一、被告三书面赔礼道歉;被告二、被告三连带赔偿经济损失25万元;驳回其他诉讼请求。宣判后双方均未上诉,判决已生效。
焦点一:AI合成的声音,还算不算"她的声音"
被告一方抗辩:人工智能合成后的声音产品,与自然人声音在人身权属性上有所区别;目前的技术都会对合成声音作水印标记,这切断了AI声音与自然人声音之间的联系,不具有对原告人格的可识别性。
法院没有接受这个说法。
《民法典》第一千零二十三条第二款规定:"对自然人声音的保护,参照适用肖像权保护的有关规定。"参照肖像权保护,前提是可识别性——他人在反复多次或长期聆听的基础上,能通过声音特征识别出特定自然人。
那么AI处理过的声音呢?法院给出的判断口径是:关键在于通过该声音是否仍能识别出该特定自然人。如果一般社会公众或相关领域的公众,根据音色、语调和发音风格,能把它关联到某个自然人,就认定具有可识别性。
落到本案:被告三仅使用殷某某个人声音开发这款产品;一审庭审当庭勘验,现场用该产品做文本转语音操作,得到的AI声音与殷某某的音色、语调、发音风格高度一致。法院据此认定,案涉AI声音属于殷某某声音权益的保护范围。
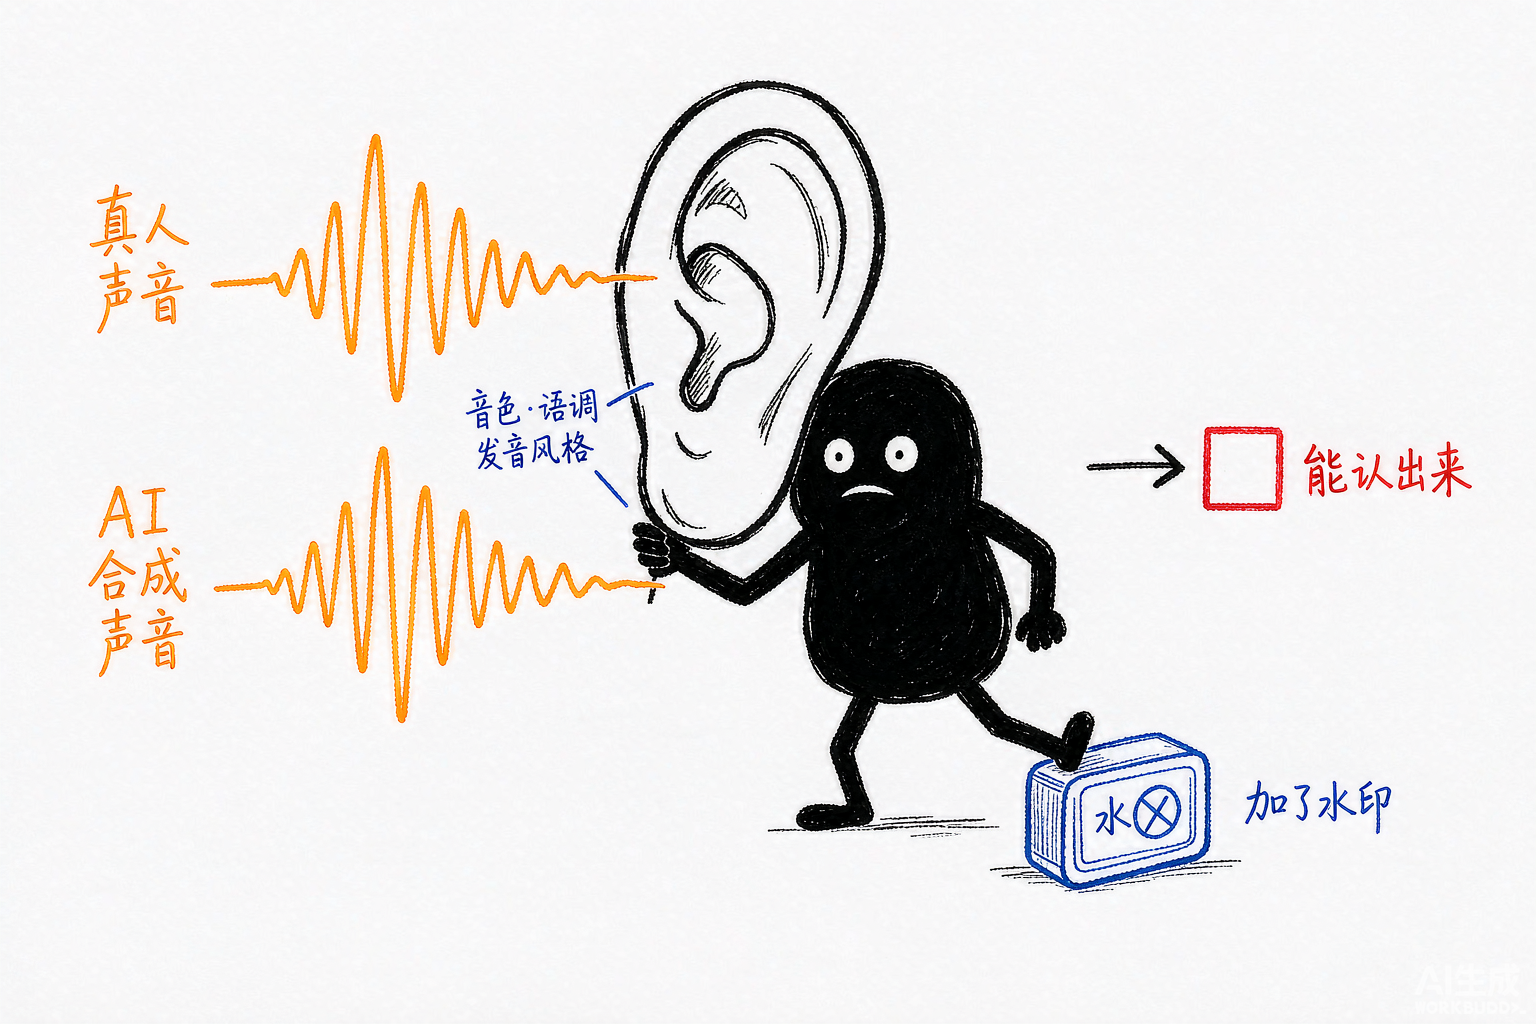
判断标准是"能不能听出来是谁",水印不改变这个判断
注意: 法院讲的是"能认出来就受保护",而不是"所有AI声音都受保护"。加水印这类技术标记,并不影响公众能否听出这是谁的判断。
焦点二:有录音制品著作权,能不能授权AI化使用
这是本案最容易被忽略、也最容易踩坑的一点。
某文化公司是录音制品的著作权人,这一点法院认可。但法院明确指出:它对录音制品享有的权利,不包括授权他人对殷某某声音进行AI化使用的权利。
原因在于这是两层权利。录音制品的著作权是财产性权利,归制作者;声音权益是人格性权利,归自然人本人。两者不能打包转让,前者也不覆盖后者。
更关键的是那份《数据授权书》——并非殷某某本人签署。因此,被告二与被告三签约、在殷某某不知情且未同意的情况下授权被告三对原告声音作AI化使用,无合法权利来源。
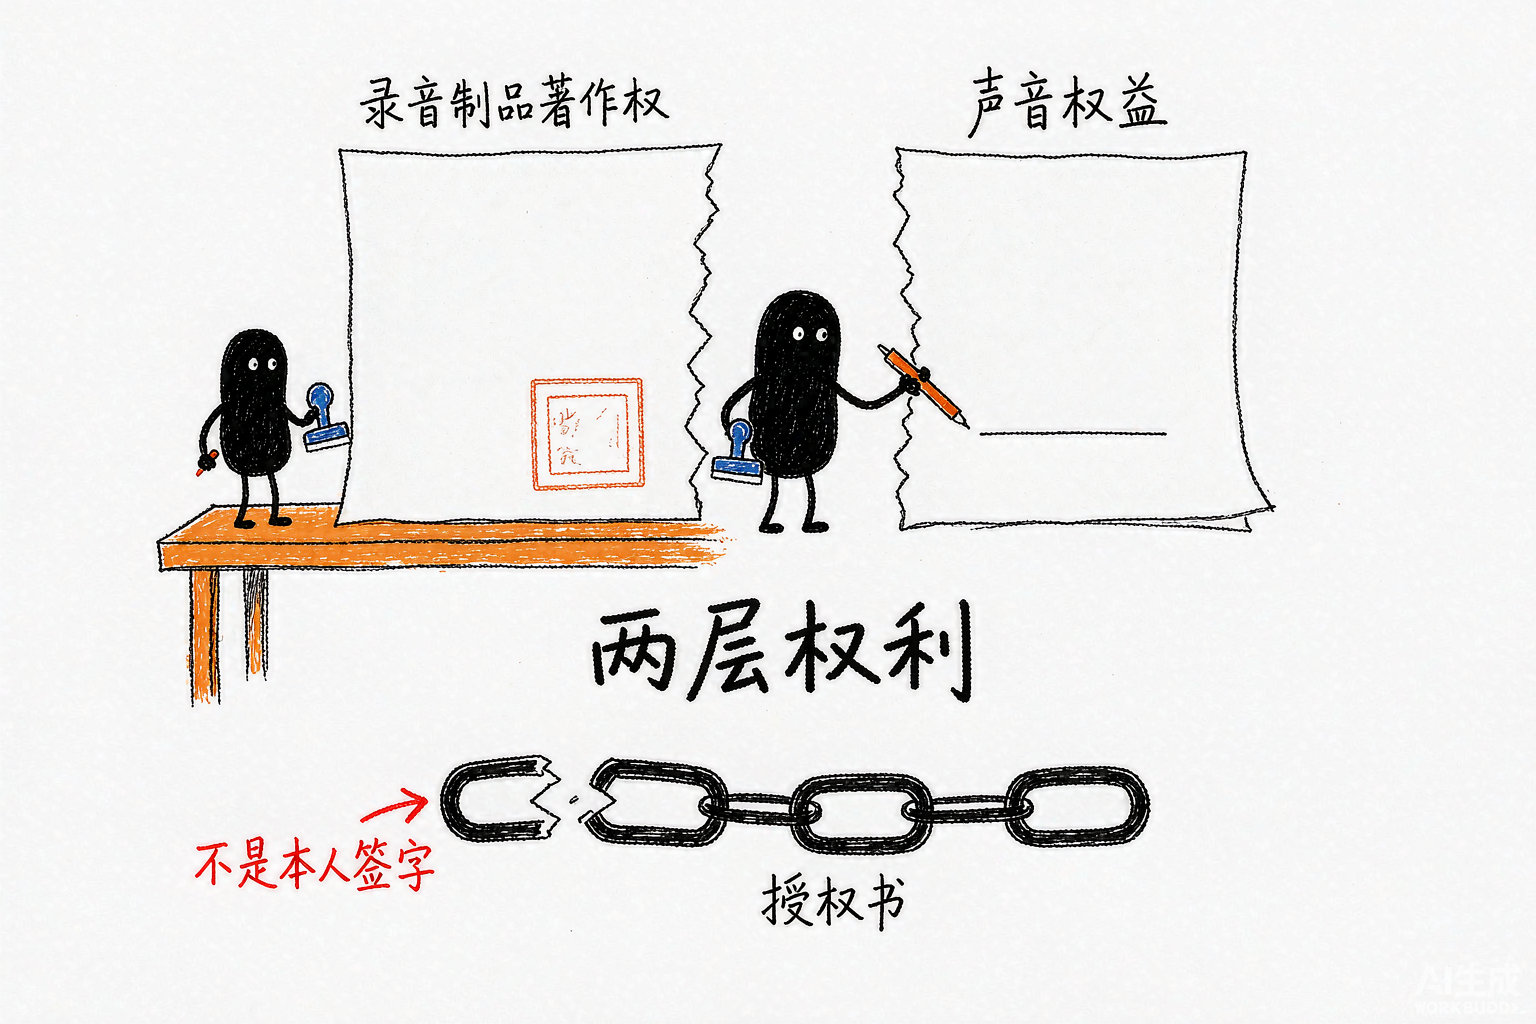
录音制品著作权 ≠ 声音权益——授权链从源头就断了
换句话说: 这条数据授权链从源头就断了:最上游缺一份本人签字,后面每一环签得再规范,也站不住。
焦点三:五被告,谁赔钱,谁免责
法院不是一刀切,而是按过错把责任切开了。
被告二文化公司与被告三软件公司,未经殷某某许可AI化并使用了案涉声音,构成侵权,连带赔偿经济损失25万元。
被告一智能科技公司与被告三软件公司,需向殷某某书面赔礼道歉。
被告一、被告四、被告五主观上不存在过错,不承担损害赔偿责任。
这里有个耐人寻味的差别:被告一虽然免于赔偿,却仍要赔礼道歉。因为它是直接面向用户的一端,以API形式直接调取、未作技术处理就投入使用;而被告四(云服务平台)、被告五(采购方)处在通道与采购环节,既无过错,也未被判赔礼道歉。
至于赔偿数额,法院考量了侵权情节、同类市场产品价值等因素,50万元的经济损失诉请支持了25万元;10万元精神损害抚慰金未获支持,理由是殷某某未举证证明被诉侵权行为给其精神利益造成严重损害。
实务启示
AI声音产品的授权链条要一查到底。 拿到上游的一纸授权书,不等于拿到AI化使用的权利。至少要点验四项:录音制品著作权归属、配音者本人的声音授权、授权书是否本人签署、授权范围是否明确包含"AI化处理/合成"。
"做了技术处理"不等于自动脱敏。 法院判断可识别性看的是结果——音色、语调、发音风格能否让公众关联到特定自然人。要真正降低风险,得让合成后的声音不再被公众关联到本人,而不是加一个标记了事。
链条上每一环的责任分别认定。 下游采购方、云平台若能证明自己无过错,可以不承担赔偿责任;但直接面向终端用户投放、且未作技术处理的那一端,即便主观上无过错,仍可能要承担赔礼道歉的责任。
这不是名人的特权。 《民法典》第一千零二十三条第二款写的是"自然人"。只要能被识别出来,普通人的声音同样在保护范围内。
评论精选(0)